Ich habe über die Jahre zahlreiche Dokumente gesammelt. Rechnungen, Verträge, Briefe und eingescannte Unterlagen. Vieles war irgendwo abgelegt. Nur eben nicht immer dort, wo ich später danach gesucht hätte. Es war einfach unübersichtlich, da konnte auch Paperless-ngx nicht helfen, bei der sinnvollen Sortierung und Umbenennung.
Ich habe bei der Durchsicht gemerkt, dass die Dateien nicht sinnvoll benannt waren und auch teilweise doppelt und dreifach vorhanden waren.
Also habe ich angefangen, meine Ablage mit KI-Unterstützung aufzuräumen. Mittels Nextcloud und einem MCP‑Plugin. Bei rund 1.100 Dokumenten wollte ich das nicht mehr komplett von Hand machen. Trotzdem wollte ich sehen, was mit meinen Dateien passiert.
Erst einmal herausfinden, was überhaupt vorhanden ist
Bevor etwas verschoben wird, braucht es einen Überblick. Welche Ordner gibt es? Welche Dateinamen sagen wenig über den Inhalt aus? Und welche Unterlagen gehören wahrscheinlich zusammen?
Bei dieser Durchsicht tauchte sogar mein Einstellungstest für einen Bäderbetrieb von 2013 wieder auf. Ich wusste gar nicht mehr, dass ich den noch hatte.
Das war für mich einer der schönen Nebeneffekte. Beim Aufräumen bekommt man auch wieder mit, was sich über die Jahre angesammelt hat.
Für einen eigenen Versuch würde ich mit einem kopierten Testordner beginnen. Darin reichen zunächst zehn oder zwanzig Dokumente. So lässt sich ausprobieren, ob die vorgeschlagenen Namen und Kategorien überhaupt zur eigenen Ablage passen.
Die KI muss den Inhalt erreichen können
Eine KI sieht nicht automatisch alle Dateien auf meinem Rechner oder in meiner Nextcloud. Dafür muss ich ihr Dokumente gezielt bereitstellen oder eine Verbindung mit entsprechendem Dateizugriff verwenden.
Dabei macht es einen Unterschied, ob nur Dateinamen untersucht werden oder auch der Inhalt gelesen wird. Aus „Scan001.pdf“ lässt sich kaum erkennen, ob darin eine Rechnung oder ein Versicherungsbrief steckt.
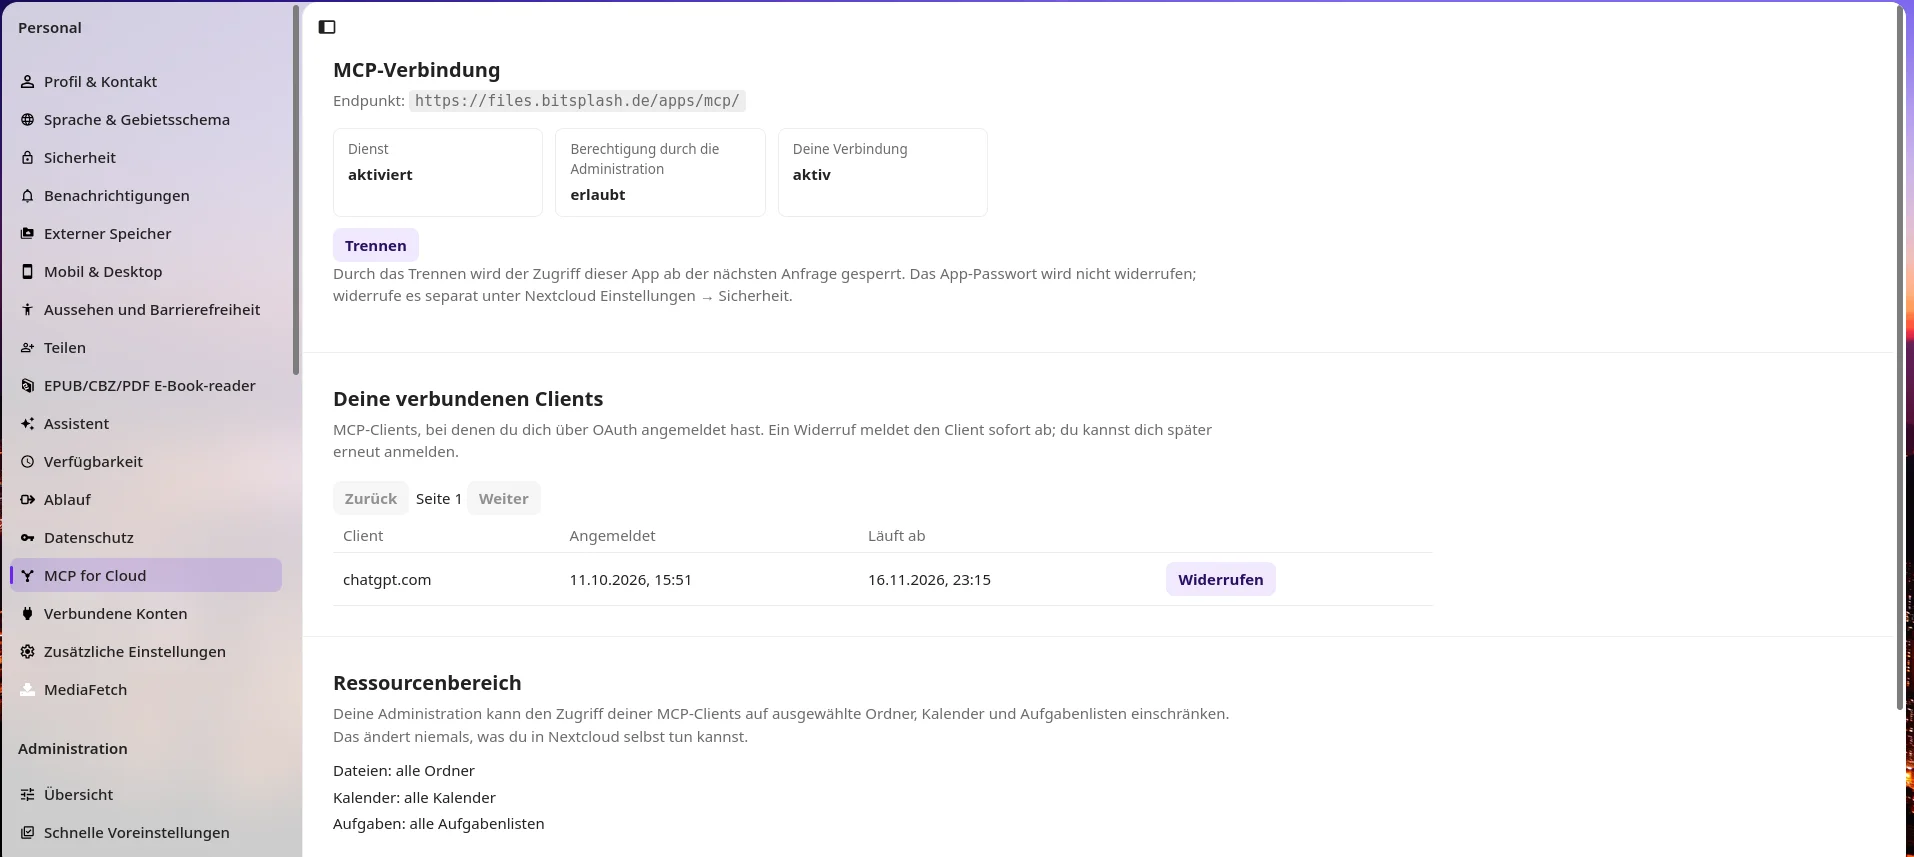
Vor der Nutzung sollte deshalb klar sein, welche Dateien der eingesetzte Dienst lesen darf und wohin ihre Inhalte zur Verarbeitung übertragen werden. Gerade bei privaten Dokumenten würde ich den Zugriff auf den benötigten Ordner begrenzen. Außerdem habe ich den Zugriff beispielsweise auf Kontakte verboten und in meinem Fall die "Das Modell für alle verbessern"-Option abgestellt. Wie es bei Claude, Mistral usw. aussieht, müsst ihr selbst herausfinden.
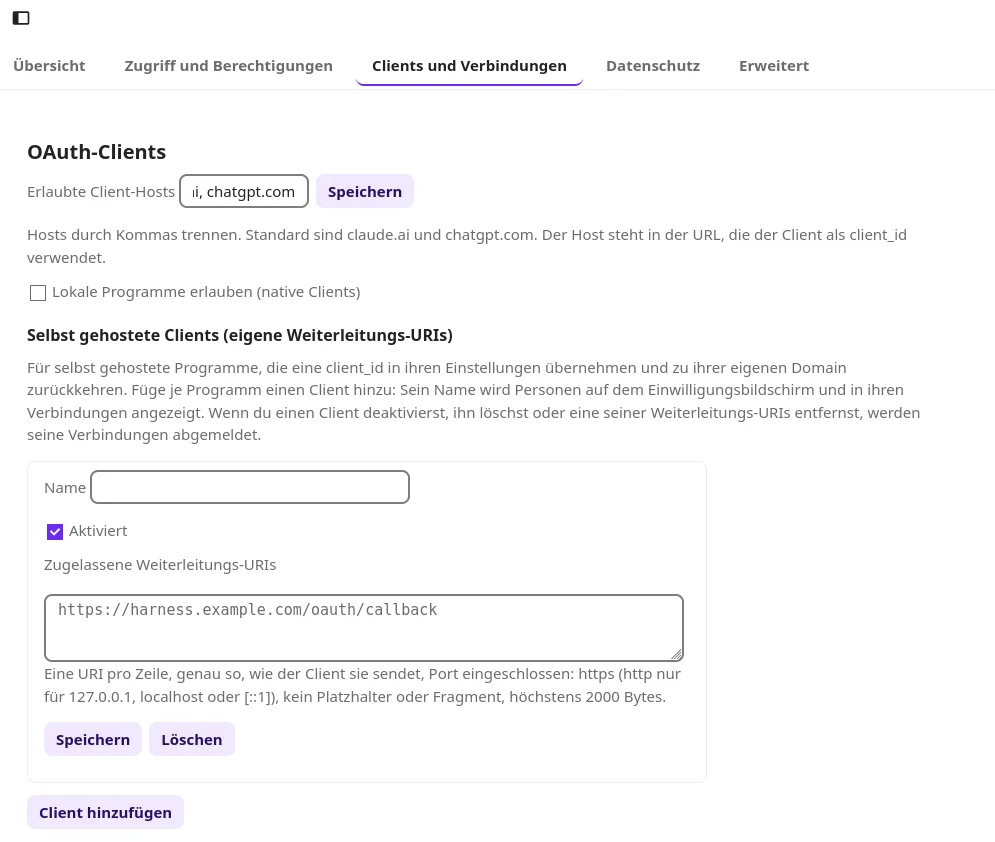
Lokales Ollama ist natürlich auch möglich. Aber dafür ist mein Server glaube ich nicht so gut und Ollama müsste erst "trainiert" werden. Also blieb es bei mir bei ChatGPT.
Verständliche Namen statt neuer Rätsel
Mir hilft ein Dateiname dann, wenn ich schon beim Lesen ungefähr weiß, was mich erwartet. Ein mögliches Muster wäre:
2024-06-15 – Kfz-Versicherung – Beitragsrechnung.pdfDas ist ein Beispiel, keine Vorgabe für jede Datei. Entscheidend ist, dass das Datum zum Dokument gehört und die Beschreibung stimmt. Fehlt eine Angabe, soll die KI sie nicht einfach ergänzen.
Auch die Ordnerstruktur muss nicht besonders ausgefeilt sein. Einige nachvollziehbare Bereiche sind für mich hilfreicher als viele Unterordner, zwischen denen ich später wieder überlegen muss.
Mein Prompt
Mein Prompt war folgender:
Durchsuche und Ordne sowie benenne die Dateien unter /Dokumente/Import Paperless entferne doppeltes Datum sowie Bezeichnungen sowie die Fortlaufende Nummer. Sortiere die Dateien in /Dokumente ein @Nextcloud MCP und gib mir Vorschläge was gelöscht werden könnte und gib mir vorher eine Übersicht, was umbenannt oder gelöscht werden soll.
Aber mit einem Prompt ist es nicht getan, insgesamt waren es, glaube ich, um die 15 Prompts und generierte Skripte, die mir geholfen haben, das alles zu sortieren.
Vorschläge anzeigen lassen und selbst prüfen
Ich habe mir die Änderungen zunächst zur Durchsicht vorlegen lassen. Dabei sollte für jede Datei erkennbar sein:
Wie heißt sie bisher?
Welchen Namen soll sie bekommen?
In welchen Ordner soll sie verschoben werden?
Dazu passt beispielsweise dieser Auftrag:
Prüfe die Dokumente und schlage verständliche Dateinamen sowie passende Zielordner vor. Verschiebe noch nichts. Erfinde keine fehlenden Angaben und kennzeichne unsichere Zuordnungen.
Nach den ersten Durchsichten habe ich die Pakete auf jeweils 100 Dokumente vergrößert. Für meine Sammlung war das ein brauchbarer nächster Schritt. Wer viele schwer lesbare Scans hat, bleibt besser zunächst bei kleineren Gruppen.
Ähnlich bedeutet noch lange nicht doppelt
Bei meinen mehrfach vorhandenen Auto-Ordnern lag der Gedanke nahe, einfach einen davon zu entfernen. So einfach ist es aber nicht.
Zwei Schreiben derselben Versicherung können unterschiedliche Zeiträume betreffen. Eine Datei kann zusätzliche Seiten enthalten. Und ein neuerer Scan kann besser lesbar sein als die ältere Fassung.
Deshalb würde ich zunächst nur mögliche Doppelungen markieren lassen. Vor dem Löschen müssen die betreffenden Dateien verglichen werden. Im Zweifel bleiben beide erhalten.
Änderungen nachvollziehbar halten
Nach meiner Freigabe können die geprüften Dateien umbenannt und verschoben werden. Dazu gehört für mich ein Protokoll mit dem alten und neuen Speicherort. Eine getrennte Sicherung bleibt bestehen, bis ich die Ergebnisse kontrolliert habe.
Die KI nimmt mir damit einen großen Teil der Sortierarbeit ab. Meine Aufgabe bleibt, unklare Fälle zu entscheiden und zu prüfen, ob die Ablage im Alltag funktioniert.
Denn schön benannte Ordner bringen mir wenig, wenn ich die nächste Rechnung darin wieder nicht finde.
Gedanken dazu 0 Kommentare
Noch ist es ruhig hier. Dein Gedanke könnte der erste sein.
Du kannst den Link auch in der Suche deiner eigenen Instanz öffnen. Öffentliche Antworten und bei Sharkey auch Home-Antworten können hier als Kommentare erscheinen. Antworten anderer Personen erscheinen nach Freigabe, deine eigenen direkt nach dem Abruf. Antworten nur für Follower werden nicht übernommen.
Was denkst du dazu?
Dein Kommentar erscheint nach der Freigabe.